Bevor wir uns mit dem Prager Kosmik Compute auf eine Partnerschaft einigten, haben wir sein Modell an 35 realen Kundentranskriptionen getestet. Es kam 9,7× günstiger heraus als Claude Sonnet, mehr, als Kosmik selbst bewirbt.
Bevor wir uns mit dem Prager Kosmik Compute auf eine Partnerschaft einigten, haben wir sein Modell an 35 realen Kundentranskriptionen getestet. Es kam 9,7× günstiger heraus als Claude Sonnet, mehr, als Kosmik selbst bewirbt. Im Artikel stehen der ganze Test, ein Ersparnisrechner und vor allem, was Ihr Unternehmen davon hat: Daten in Prag, KI-Betrieb zu einem Bruchteil des Preises und ein Team, das es einrichtet.
Zuerst der Test, dann der Name unter dem Angebot
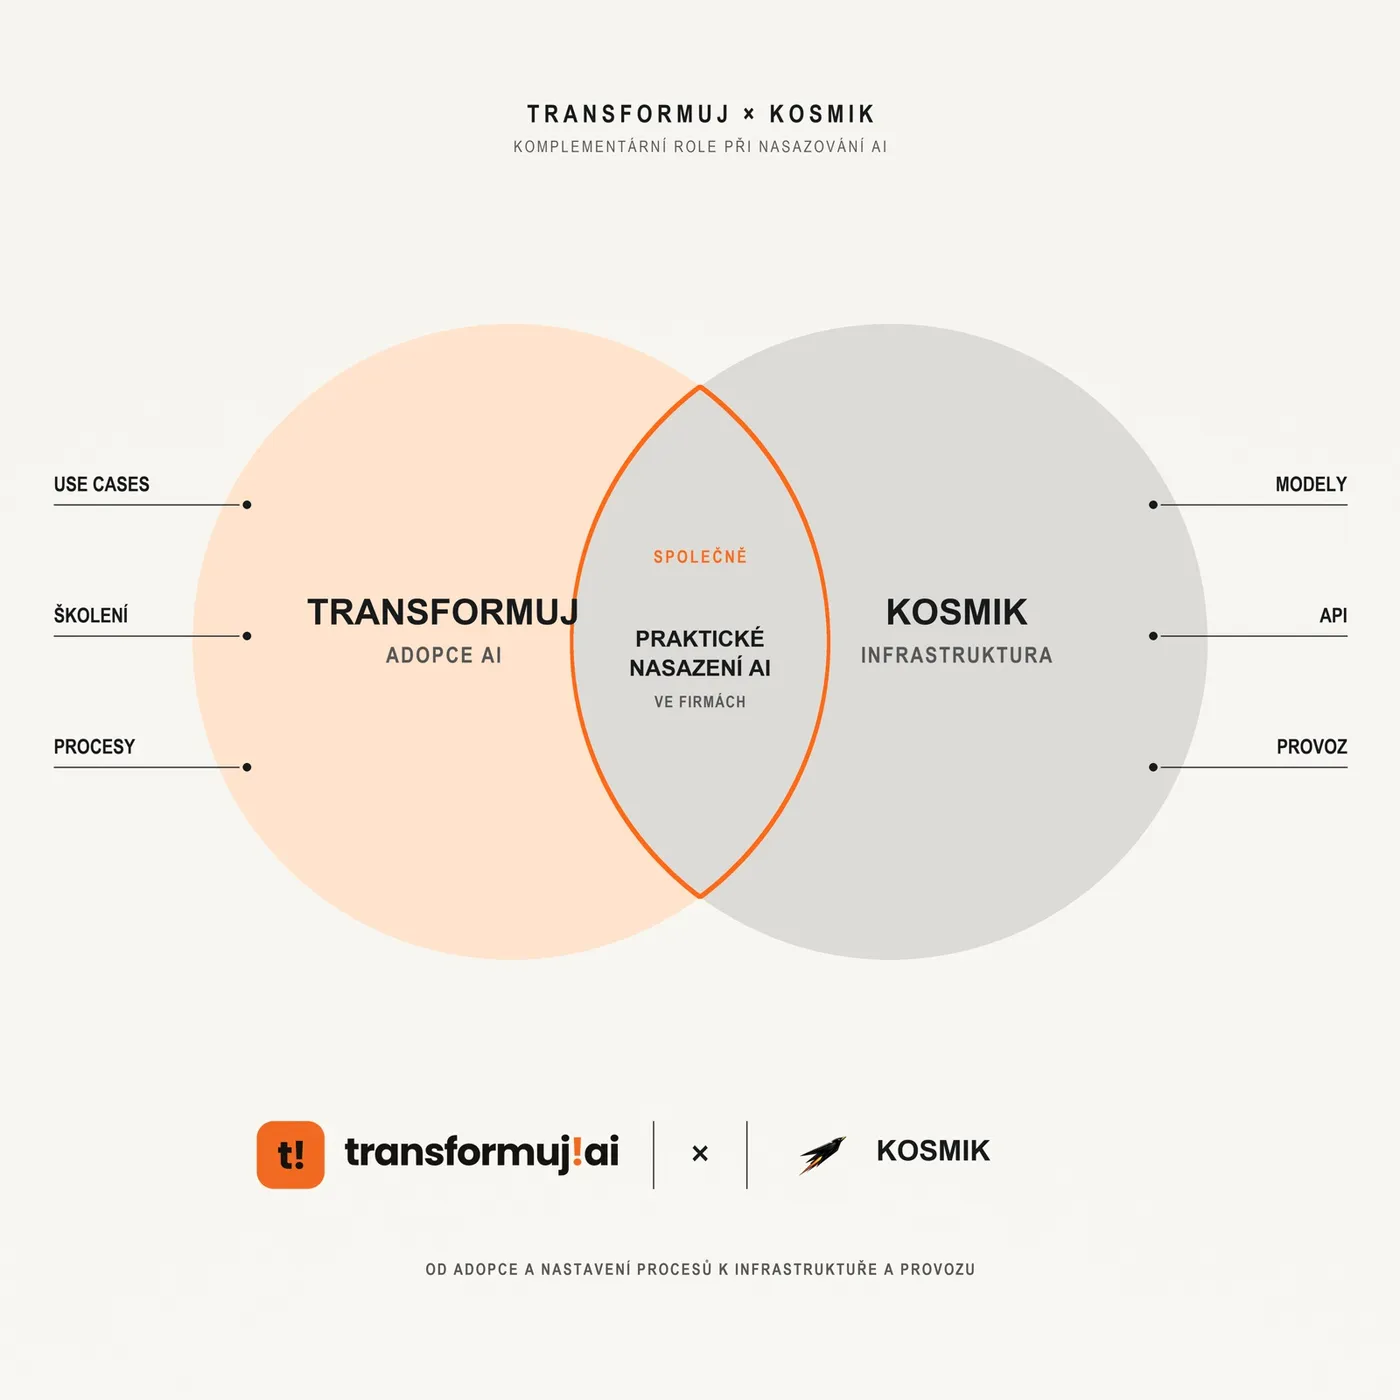
Transformuj.ai arbeitet offiziell mit Kosmik Compute zusammen, einer Prager KI-Infrastruktur mit günstigerer Inferenz. Die Rollenverteilung ist einfach: Kosmik sorgt für Rechenleistung, den Preis pro Token und Daten in Prag, wir bauen darauf Lösungen auf und bringen den Leuten in Unternehmen bei, mit KI zu arbeiten.
Bevor wir Ja sagten, haben wir ihr Modell an einer eigenen Produktivaufgabe getestet: 35 reale Kundentranskriptionen, mit denen wir normalerweise arbeiten. Keine Demo von ihrer Website, sondern Daten, an denen uns liegt. Erst nach dem Test haben wir eingeschlagen. Auf die Reihenfolge kommt es an: zuerst die Zahlen, dann der Name unter dem Angebot.
Was Ihr Unternehmen davon hat
KI-Betrieb 9,7× günstiger. Gemessen gegen Claude Sonnet an unserem realen Datensatz, nicht auf einer Marketingfolie. Kosmik selbst bewirbt auf seiner Website 9,1×. Bei Extraktionsaufgaben mit Übergewicht des Eingabetextes, und das ist der Großteil der Routine in Unternehmen, fällt ihr Angebot noch besser aus, als sie es selbst verkaufen.
Die Daten bleiben in Prag. Kosmik gibt an, dass Prompts weder protokolliert noch gespeichert werden und mit den Daten nicht trainiert wird. Die Hardware läuft in einem zertifizierten Rechenzentrum in Tschechien, und der Betrieb entspricht der DSGVO. Für Gesundheitswesen, Recht, Finanzen und öffentliche Verwaltung ist das oft wichtiger als der Preis.
Wir richten es ein und schulen die Leute. Ein billiger Token spart für sich allein nichts. Die Ersparnis entsteht erst, wenn die KI eine konkrete Routineaufgabe übernimmt: Dokumente, E-Mails, Inhalte, Code. Genau das ist unser Teil der Arbeit.
Der Test: 35 Transkriptionen, null Fehler
Der Test lief am 27. 7. 2026 am Modell Qwen 3.6 27B, dem einzigen, das wir tatsächlich getestet haben: 35 reale Kundentranskriptionen, 320.346 Eingabe- und 16.724 Ausgabetoken, Gesamtzeit 2,1 Minuten.
Was passte: 35 von 35 Transkriptionen ohne Fehler und ohne Notwendigkeit, die Anfrage zu wiederholen. Null halluzinierte Zahlen, jede Angabe ließ sich im Quelltext nachweisen. Die strukturierte Ausgabe traf alle 12 verlangten Felder auf Anhieb. In 400 Betriebsprotokollen fand das Modell alle drei außerordentlichen Ereignisse und summierte den Schaden richtig. Tschechisch ohne Fehler. Bei zwei unbrauchbaren Transkriptionen schrieb das Modell selbst, dass sie sich nicht analysieren lassen, statt den Inhalt zu erfinden, genau das Verhalten, das wir von einem Extraktionstool wollen.
Umfang des Tests. Das Kontextfenster haben wir bis 34.700 Token von den angegebenen 262.000 geprüft, die Aufgaben waren Extraktionsaufgaben, und gemessen haben wir in der kostenlosen, geteilten Stufe (Free Tier). Copywriting ist eine andere Aufgabe, das Modell ist für Datenextraktion gebaut, für Text nach außen setzen wir es nicht ein. Durchsatz: in der kostenlosen Stufe 98,6 Token pro Sekunde, Kosmik gibt für die Produktionsstufe 3.832 bei kurzen Chats und 1.467 bei längerer Arbeit an. Die Produktionsstufe haben wir nicht gemessen, es sind Zahlen aus zwei verschiedenen Umgebungen.
Was alles bei Kosmik läuft
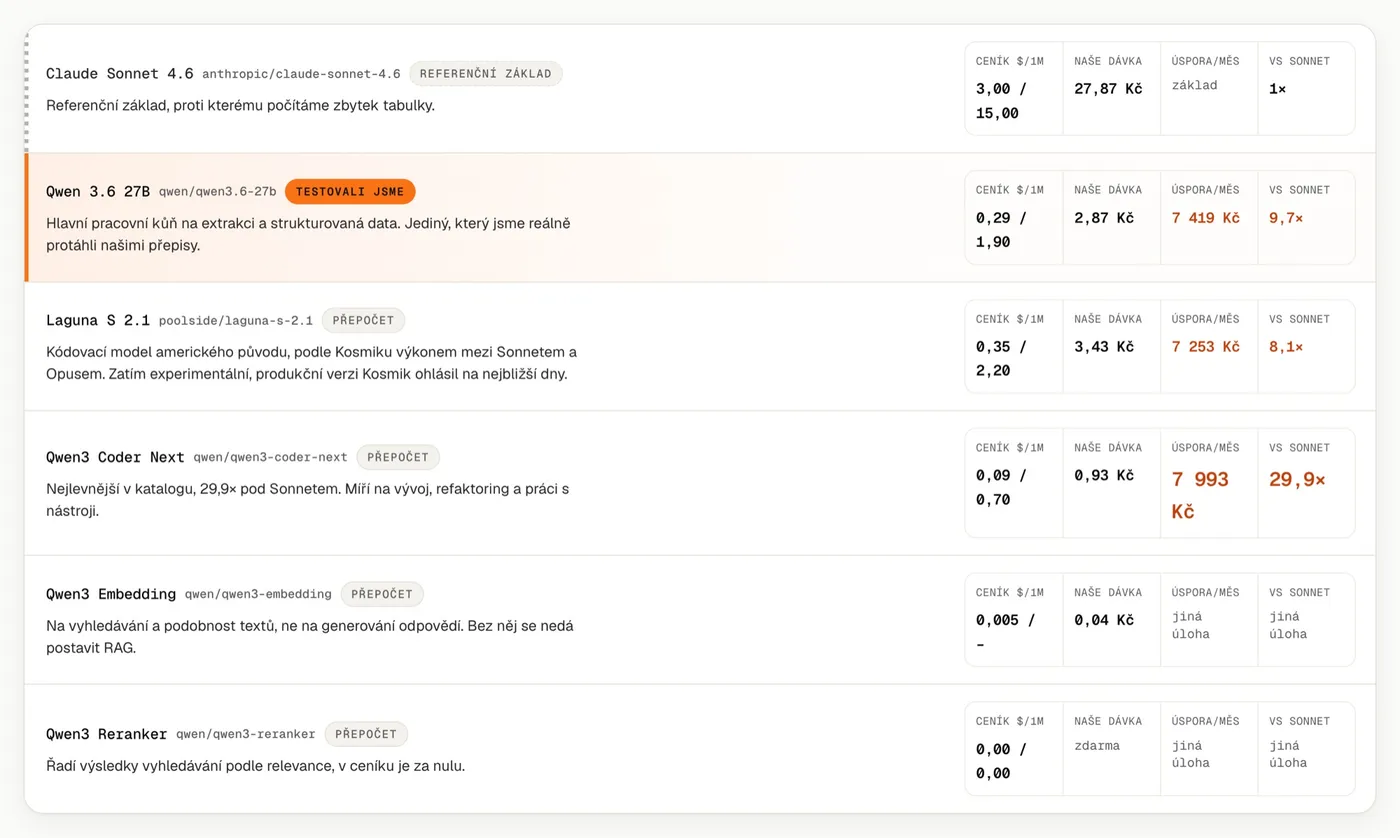
Kosmik hat im Katalog mehrere Modelle, wir haben bisher eines getestet. Bei den anderen handelt es sich um eine Umrechnung der öffentlichen Preisliste auf unseren Datensatz, Kurs 0,92 € pro Dollar.
Die auffälligste Zahl in der Tabelle ist nicht unsere. Das Code-Modell qwen3-coder-next kommt mit demselben Datensatz 29,9× günstiger heraus als Sonnet. Für Startups und Entwicklungsteams ist das eine Größenordnung, die das Budget für Iterationen verändert.
Die Anbindung ist Konfiguration, kein Projekt. Die API ist mit OpenAI und Anthropic kompatibel, eine bestehende Anwendung stellen Sie durch Änderung von zwei Variablen um.
Wie viel es tatsächlich spart
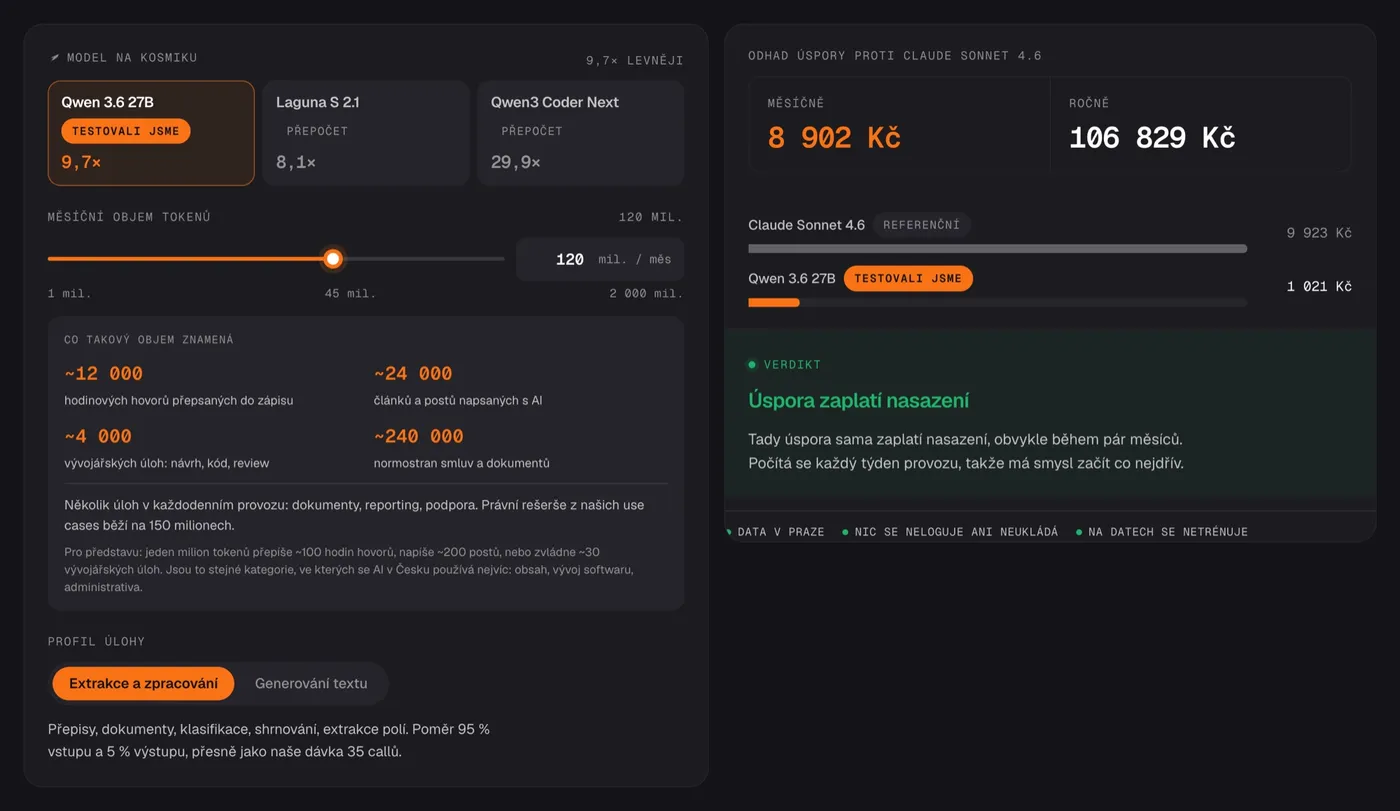
Die Ersparnis wird in Token pro Monat gerechnet, nicht in Prozent.
Kleine Mengen, bis 20 Millionen Token monatlich. Die Ersparnis liegt zwischen einigen Euro und niedrigen dreistelligen Beträgen, eher ein Bonus. Das Hauptargument ist der Betrieb: Daten in Prag, nichts wird protokolliert, Kosten vorhersehbar.
Volumen eines kleinen oder mittleren Unternehmens, 20 bis 100 Millionen. Die Ersparnis ist im Betriebsbudget schon zu sehen. Eine medizinische Einrichtung mit 35 Millionen Token spart im Betrieb rund 1.240 € im Jahr, und vor allem: Die KI verarbeitet dafür etwa 3.500 Nachrichten im Monat, also Hunderte Stunden Arbeit des Personals.
Große Mengen. Juristische Recherche bei 150 Millionen: 5.320 € im Jahr. Softwareentwicklung mit Coder Next bei 60 Millionen: 5.712 € im Jahr. Onlineshop mit Inhaltserzeugung bei 400 Millionen: 34.896 € im Jahr, das einzige Szenario, in dem rein der Preis entscheidet.
Alles sind Modellrechnungen aus unserem Datensatz und der öffentlichen Preisliste, kein Preisangebot. Aber die Größenordnung stimmt.
Was die Daten zu Tschechien zeigen
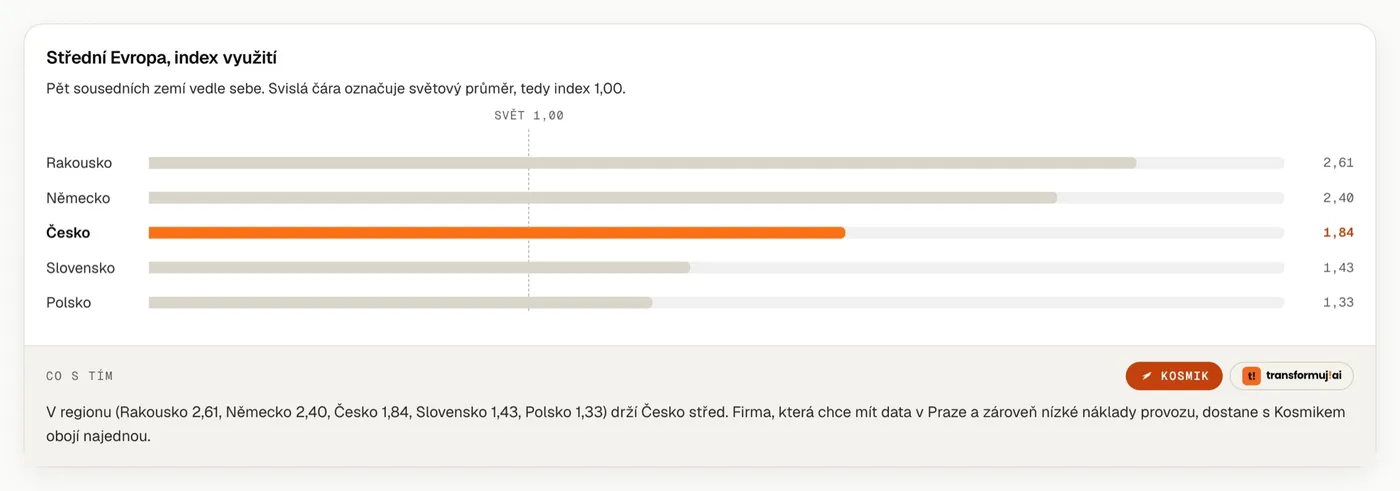
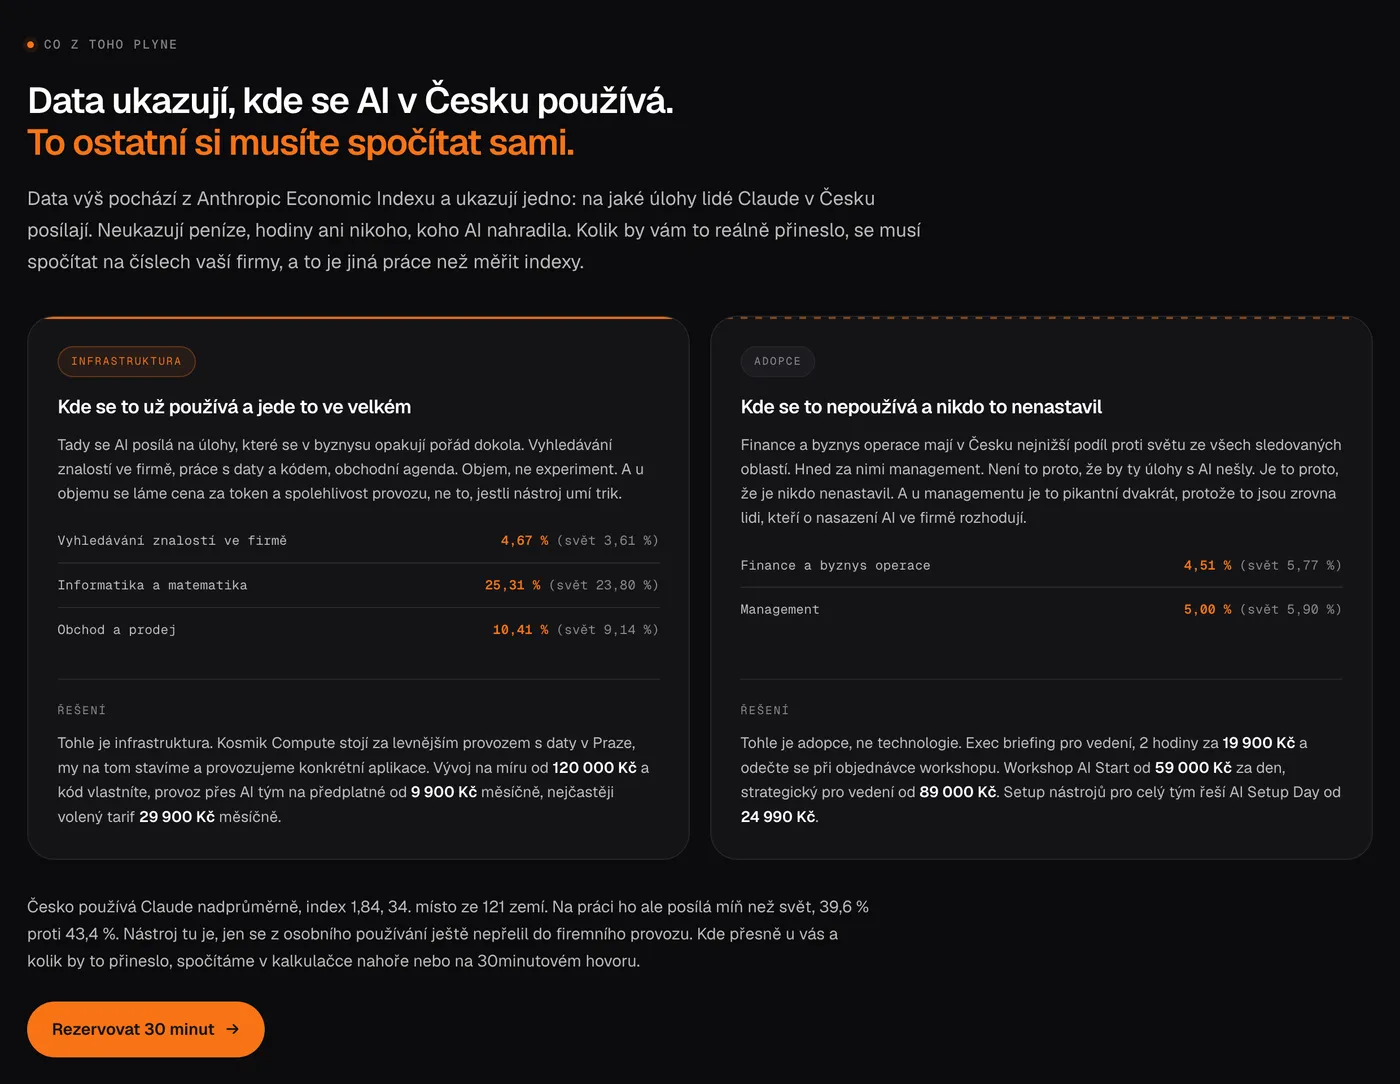
Der Anthropic Economic Index (Mai 2026, 121 Länder) misst, wie Claude wo genutzt wird. Tschechien liegt mit einem Index von 1,84 auf Platz 34 von 121 Ländern, nutzt Claude also überdurchschnittlich. Beruflich setzt es Claude aber seltener ein als der weltweite Durchschnitt, 39,6 % gegenüber 43,4 %. Das Tool ist da, es ist nur noch nicht aus der privaten Nutzung in den Unternehmensalltag übergegangen.
Am weitesten unter dem weltweiten Durchschnitt liegen Finanzen und Management, also genau die Stellen, an denen sich wiederkehrende Routine wie Reporting und Freigabeprozesse sammelt. Das liegt nicht daran, dass es mit KI nicht ginge. Niemand hat es eingerichtet.
Warum wir in die Partnerschaft gegangen sind
Der Test war eine Bedingung, keine Formalität. Er wurde bestanden, und dazu kamen Dinge, die wir beim ersten Gespräch mit Kosmik noch nicht gesehen hatten. Der Katalog bewegt sich wirklich, wir haben den Partner nicht nach einer einzigen Momentaufnahme gewählt.
Wie es weitergeht
Ein günstigerer Token ist für sich genommen kein Grund, den Anbieter zu wechseln. Zur Gleichung gehören der Speicherort der Daten, die Qualität bei einer konkreten Aufgabe und das Volumen, das das Unternehmen tatsächlich verarbeitet. Wir haben sie an eigenen Daten durchgerechnet, und sie ging so gut auf, dass wir mit unserem Namen dafür einstehen.
Rechnen Sie sie mit Ihren eigenen Daten nach.
Der Artikel ist ursprünglich auf LinkedIn erschienen. Originalartikel auf LinkedIn