Obiecałem, że druga część będzie o różnicy między stroną, aplikacją i oprogramowaniem. Ta część nadal nadejdzie.
Obiecałem, że druga część będzie o różnicy między stroną, aplikacją i oprogramowaniem. Ta część nadal nadejdzie. Ale w weekend 1 i 2 sierpnia w apce Ptáček znalazł się błąd i ta obiecana różnica zamiast w tabeli rozegrała się na żywo.
Pokazanie jej na prawdziwym błędzie jest uczciwsze niż tłumaczenie na przykładach z głowy. Więc kolejność się zmienia.
Jest w tym też drugi powód. Chcę, żeby było widać, jak naprawdę wygląda rozwój z AI. Nie tylko gotowe demo na końcu, ale i chwile, gdy się to psuje, gdy szuka się przyczyny i gdy dwa razy wraca się o krok wstecz, zanim zadziała. Vibe Coding sprzedaje się jako magię. W rzeczywistości to rzemiosło z błędami, które się rozwiązuje.
Co się zepsuło i dlaczego cisza jest gorsza niż awaria
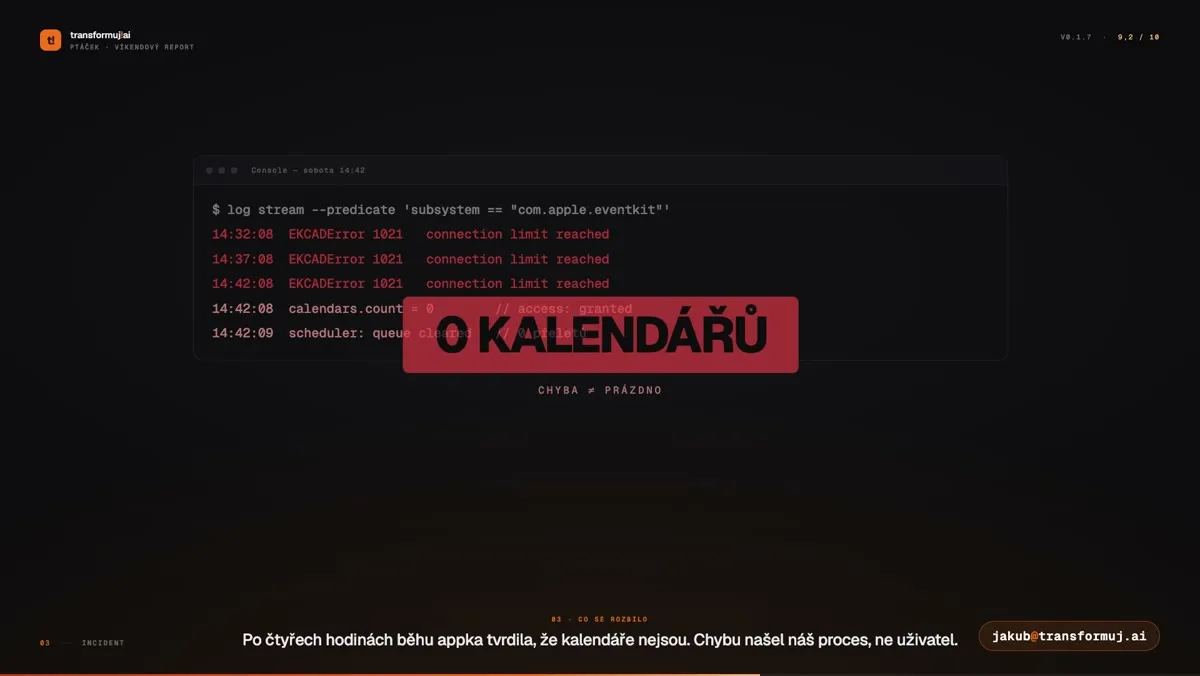
Ptáček co pięć minut pytał systemowy kalendarz, czy coś się szykuje. Problem tkwił w tym, jak pytał. Na każde zapytanie otwierał nowe połączenie, a stare zostawiał otwarte. Po mniej więcej czterech godzinach pracy macOS odmówił mu kolejnego połączenia.
Gorsza była druga połowa błędu. Apka zamiast komunikatu o błędzie dostała pustą odpowiedź i uznała ją za prawidłową. Żadnych kalendarzy, żadnych spotkań. Skasowała nawet przeloty, które miała już zaplanowane. W ustawieniach przy tym świeciło na zielono, że dostęp do kalendarza działa.
W apce, która ma przelecieć przez ekran kilka minut przed spotkaniem, jest to szczególnie przykre. Człowiek na niej polega i przestaje sam pilnować kalendarza. Gdy potem milczy, zamiast powiedzieć nie wiem, jest gorsza, niż gdyby jej w ogóle nie było.
W apce z przypomnieniami najgorszy błąd to nie awaria. Najgorsza jest cisza.
Kto to znalazł: dwa audyty i jedna korekta
Na przyczynę wysłałem dwa niezależne audyty. Dwa różne modele, każdy z własnym zadaniem, oba z dostępem do odczytu kodu i działającej apki. O sobie nawzajem nie wiedziały.
Pierwszy znalazł przyczynę bezpośrednio w kodzie: trzy miejsca, w których otwiera się nowe połączenie zamiast ponownie użyć starego. Od razu zabronił rozwiązań typu „podnieśmy limit połączeń”, bo ten sam problem by tylko odsunęły.
Drugi potwierdził to własnym ustaleniem z logu i w jednym punkcie poprawił pierwszego.
Wniosek, który z tego wynoszę: jeden audyt daje niepotwierdzony wniosek. Dwa niezależne audyty dają zgodność co do przyczyny i do tego jedną korektę, na którą pierwszy sam by nie wpadł.
Błędu przy tym nigdy nie spotkał żaden użytkownik. Wychwycił go nasz proces testowy w sobotę wieczorem, a nie ktoś obcy w poniedziałek rano.
Co naprawiono: architektura, nie łatka
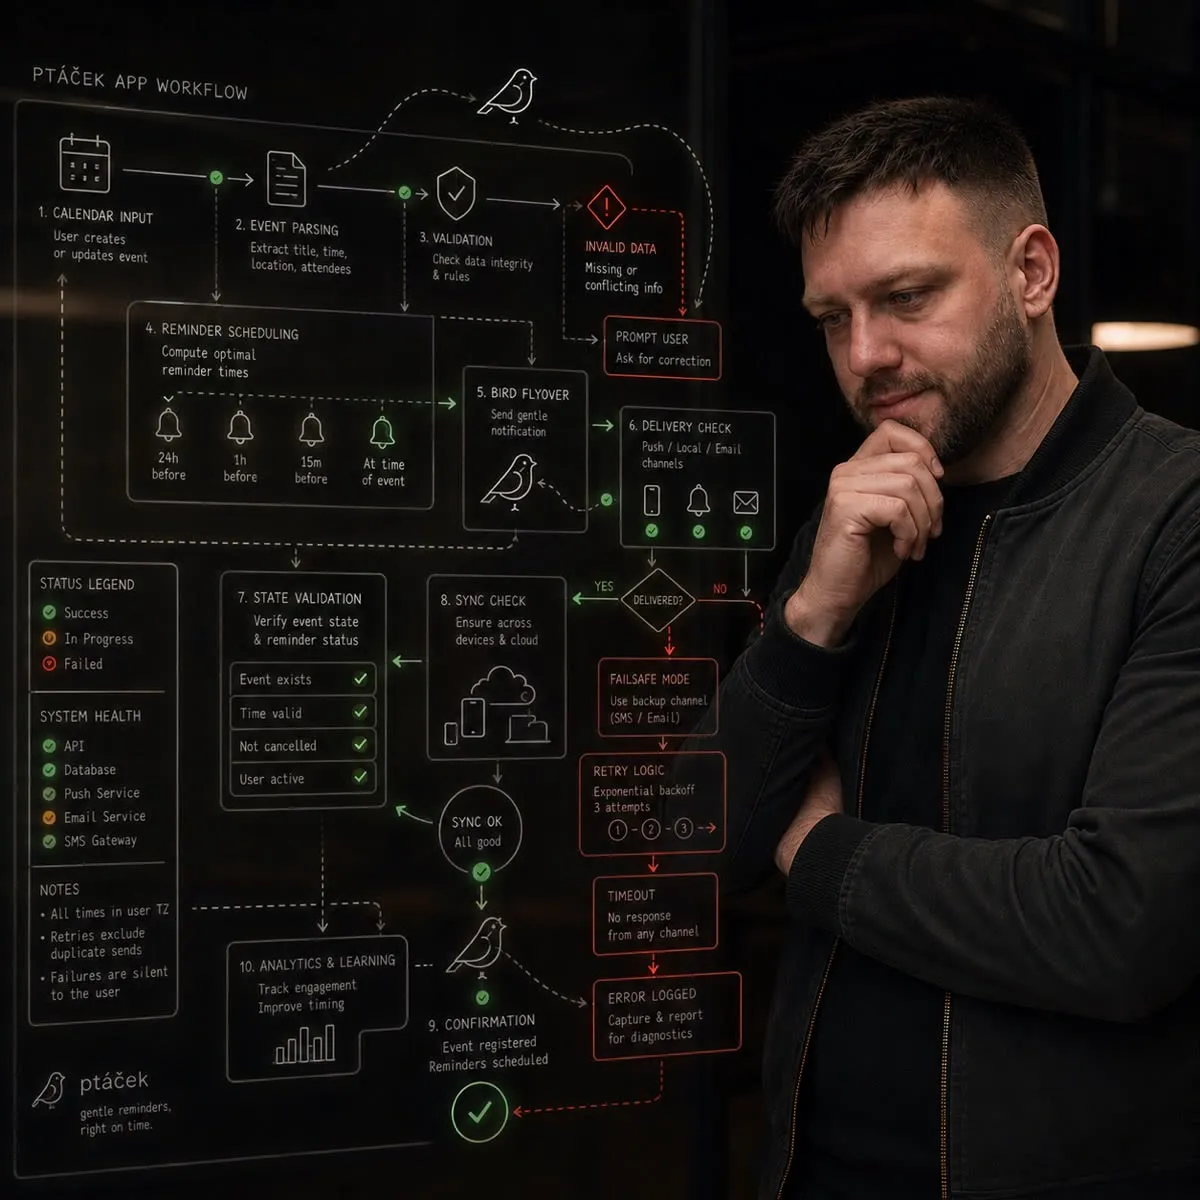
Naprawa nie polegała na „podnieśmy limit” ani „dodajmy ponawianie zapytania”. Zmieniło się to, jak apka rozmawia z kalendarzem.
Jedno połączenie na cały czas działania apki zamiast nowego przy każdym zapytaniu. Błąd już nigdy nie wygląda jak pustka. Gdy apka nie wie, mówi nie wiem i zostawia w mocy ostatni potwierdzony plan, zamiast przełożyć sobie pustkę na „żadnych spotkań”. Reakcja na zmianę spotkania w ciągu sekundy zamiast do pięciu minut.
Jest różnica między „już nie świeci na czerwono” a „już się to nie dzieje”. To drugie oznacza zrozumieć, dlaczego to się działo, i przepisać tę część, a nie ją zakryć.
Mapa weekendu: rozwój to nie linia prosta
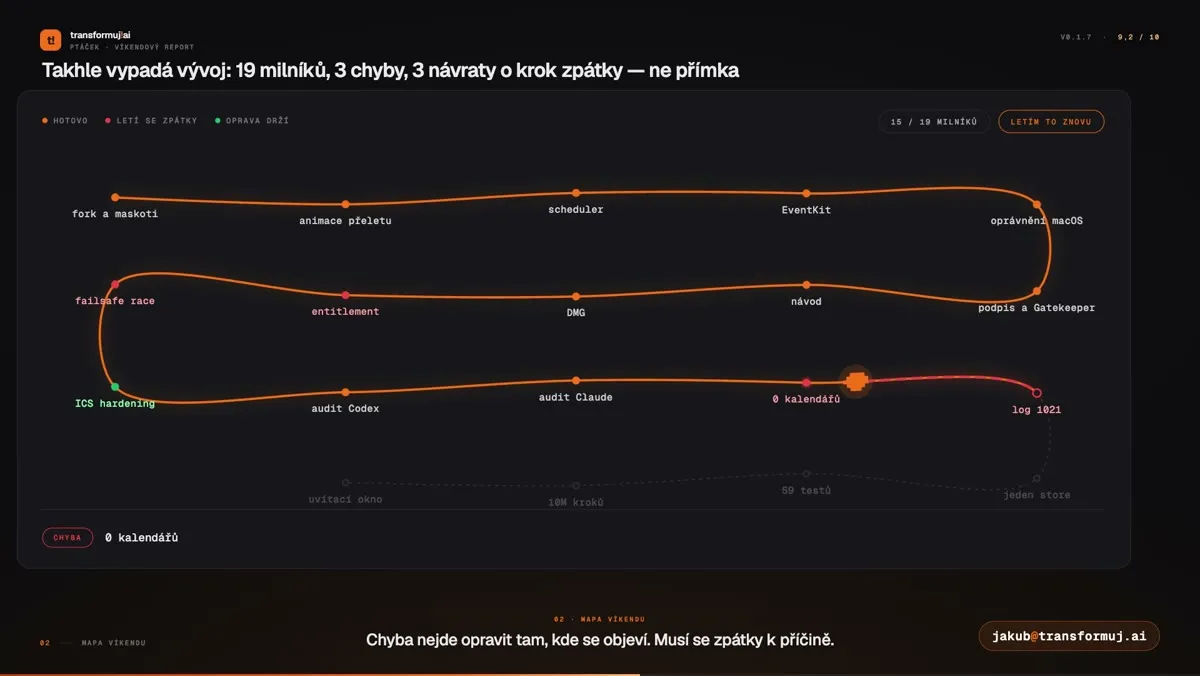
Z perspektywy czasu wygląda to na czystą historyjkę. Błąd, dwa audyty, naprawa, koniec. W rzeczywistości nie szło to tak prosto. W weekend to dziewiętnaście kamieni milowych, trzy błędy po drodze i trzy powroty o krok wstecz, gdy rozpędzona próba została odrzucona i zaczynało się od ostatniego działającego stanu.
Tego dema wideo nigdy nie pokazują.
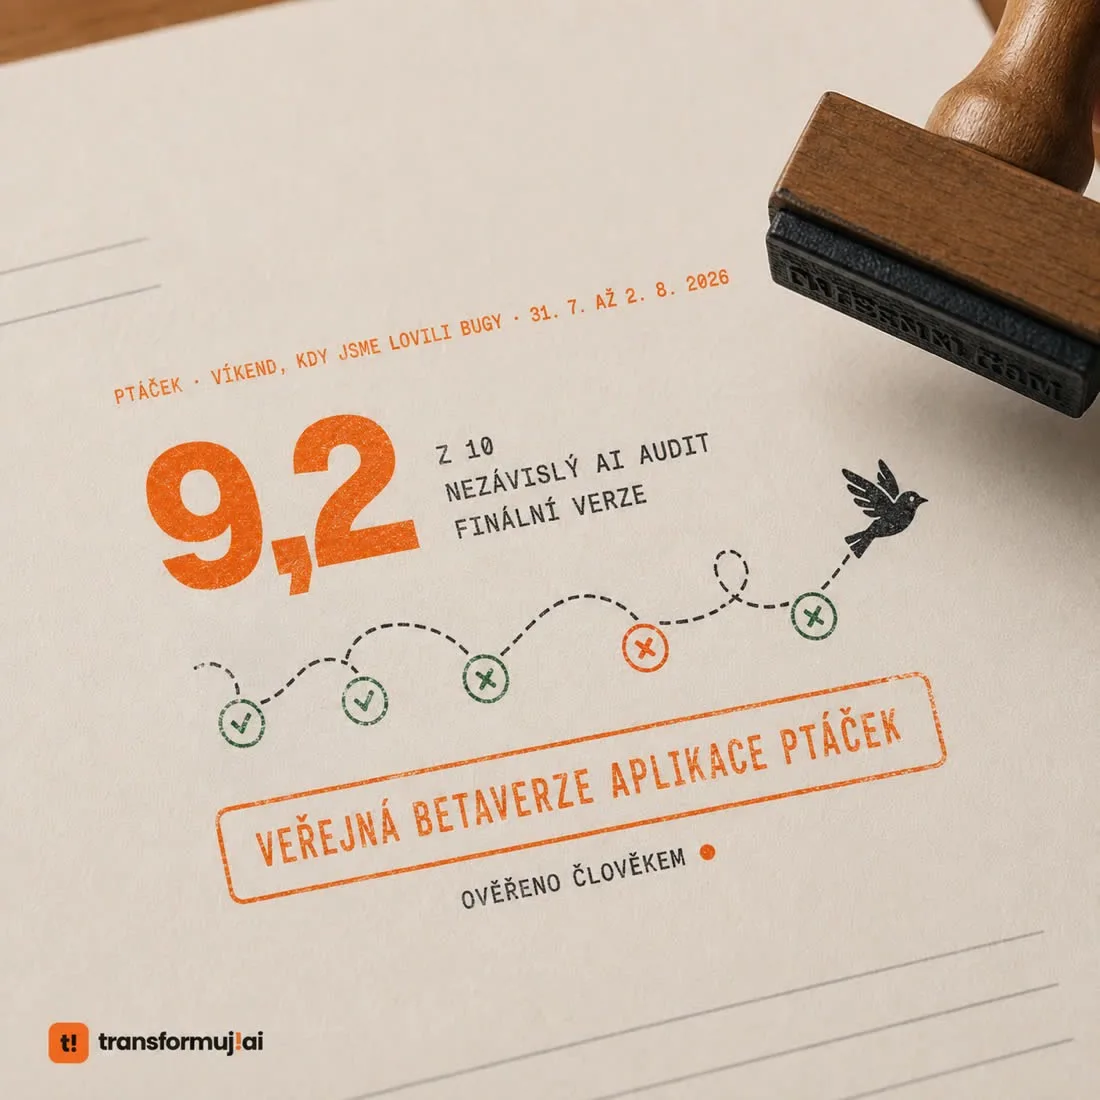
Niezależna kontrola i liczby: z 7,5 na 9,2
Po naprawie przyszła druga fala kontroli, niezależna także od obu poprzednich audytów.
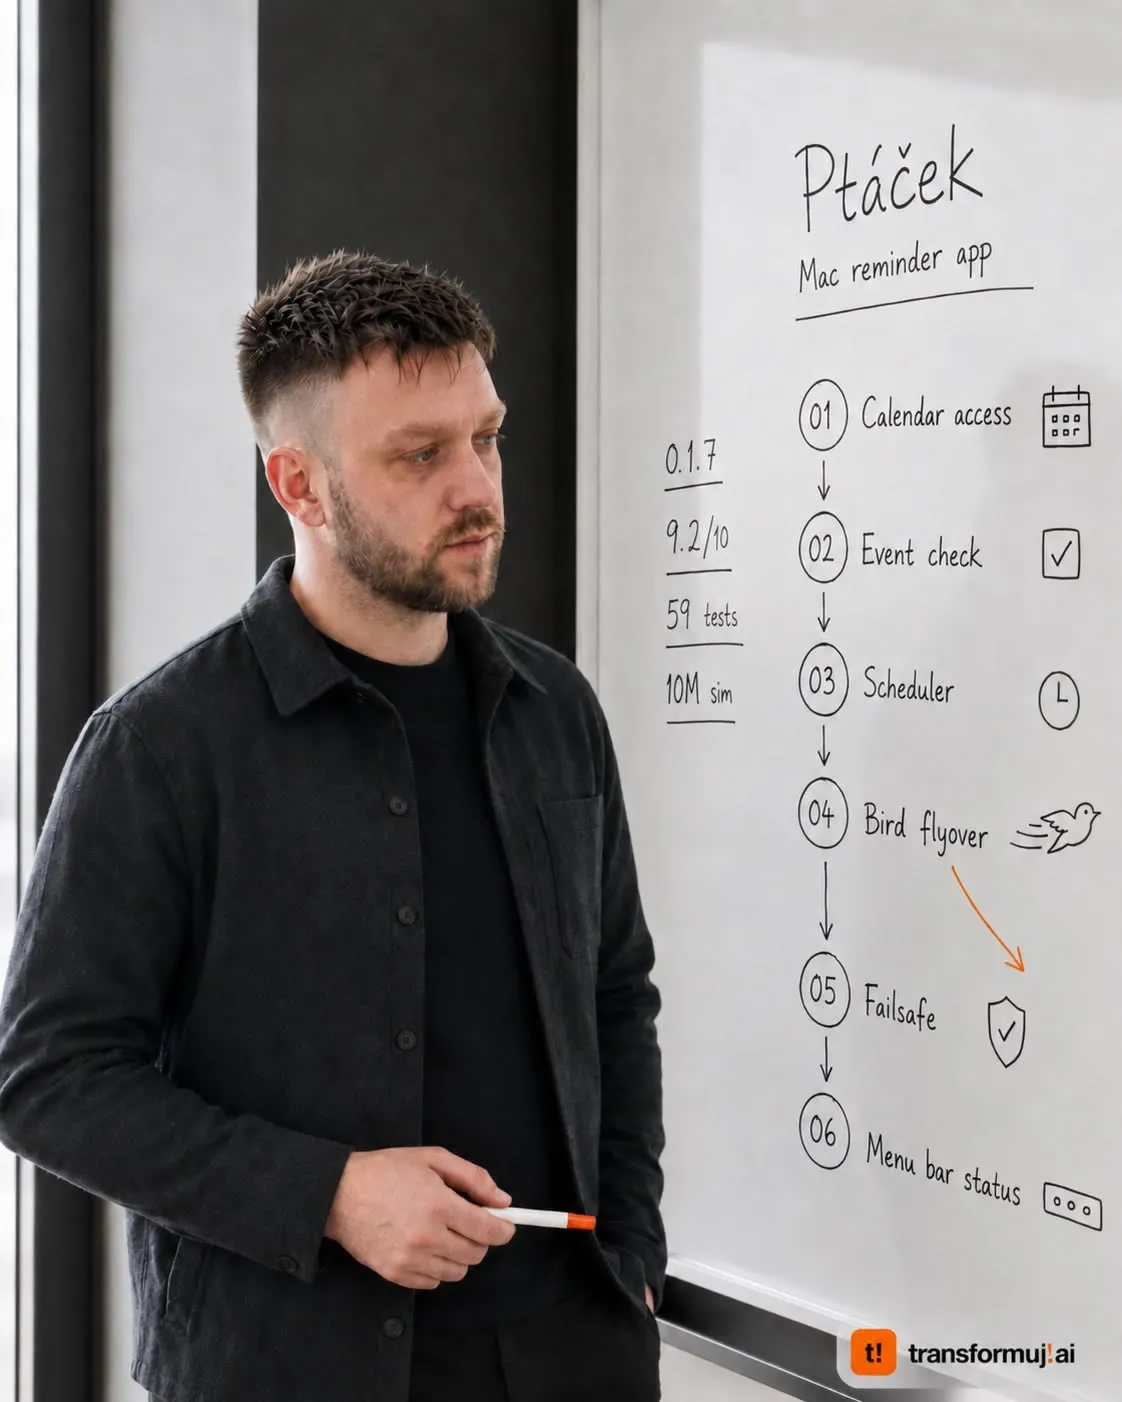
Dziesięć milionów symulowanych kroków kalendarza bez naruszenia ani jednej reguły. Milion operacji z jednym żywym połączeniem. Dokładnie to, czego w piątek brakowało. Pięćdziesiąt dziewięć testów bezpośrednio w kodzie i do tego sześćdziesiąt siedem testów własnego laboratorium QA. Czterdzieści ręcznie zaprojektowanych scenariuszy w ośmiu kategoriach.
To laboratorium potrafi rozpoznać także podsuniętą wadliwą wersję. Dostaje celowo zepsuty model i samo musi krzyknąć NO GO. Gdyby nie krzyknęło, jest do niczego. Testy, które nigdy niczego nie znajdują, są dekoracją, nie kontrolą.
Osiemdziesiąt do dwudziestu i trzy dni
Apkę w osiemdziesięciu procentach budowała AI, a pozostałymi dwudziestoma kierował i kontrolował człowiek. Zadanie, decyzję o ryzyku i ostatnie słowo miał zawsze człowiek. Bez tej kontroli weekend skończyłby się inaczej, bo audyt, który sam nigdy nie powie NO GO, jest do niczego.
Sedno nie w tym, że błędy znikną. Skraca się czas między powstaniem błędu a tym, gdy jest naprawiony i udokumentowany.
Dlaczego to zdarza się nawet Apple
Biblioteka od Apple, której Ptáček używa do czytania kalendarza, została użyta inaczej, niż Apple zamierzał. Dokumentacja mówi to jednym zdaniem ukrytym w tysiącu stron.
Zdarza się to także Apple i Google, firmom z dekadami procesów za sobą. Różnica nie polega na tym, czy dojdzie do błędu, ale jak szybko się go znajdzie i naprawi.
Trzy pytania do każdego dostawcy
Ile testów działało i co w nich zawiodło? Gdy ktoś mówi, że nigdy nic nie zawiodło, nie testowano.
Co działa dalej? Kto nie ma mapy dalszego testowania, ten jej nie robił.
Jaką to ma skalę? Strona, aplikacja i podłączenie do dwudziestoletniego systemu firmowego to trzy różne ligi. Ryzyko rośnie tak samo jak cena.
Forma promptu jest zawsze doskonała. Treść nie.
AI to turbo, nie autopilot. A turbo bez kierowcy kończy w rowie równie szybko, jak do niego wjeżdża.
Artykuł pierwotnie ukazał się na LinkedInie. Oryginalny artykuł na LinkedInie