Zanim dogadaliśmy się z praskim Kosmik Compute na partnerstwo, przetestowaliśmy ich model na 35 prawdziwych transkrypcjach klientów. Wyszło 9,7× taniej niż Claude Sonnet, więcej, niż reklamuje sam Kosmik.
Zanim dogadaliśmy się z praskim Kosmik Compute na partnerstwo, przetestowaliśmy ich model na 35 prawdziwych transkrypcjach klientów. Wyszło 9,7× taniej niż Claude Sonnet, więcej, niż reklamuje sam Kosmik. W artykule jest cały test, kalkulator oszczędności i przede wszystkim to, co z tego ma Państwa firma: dane w Pradze, eksploatacja AI za ułamek ceny i zespół, który to skonfiguruje.
Najpierw test, potem nazwa pod ofertą
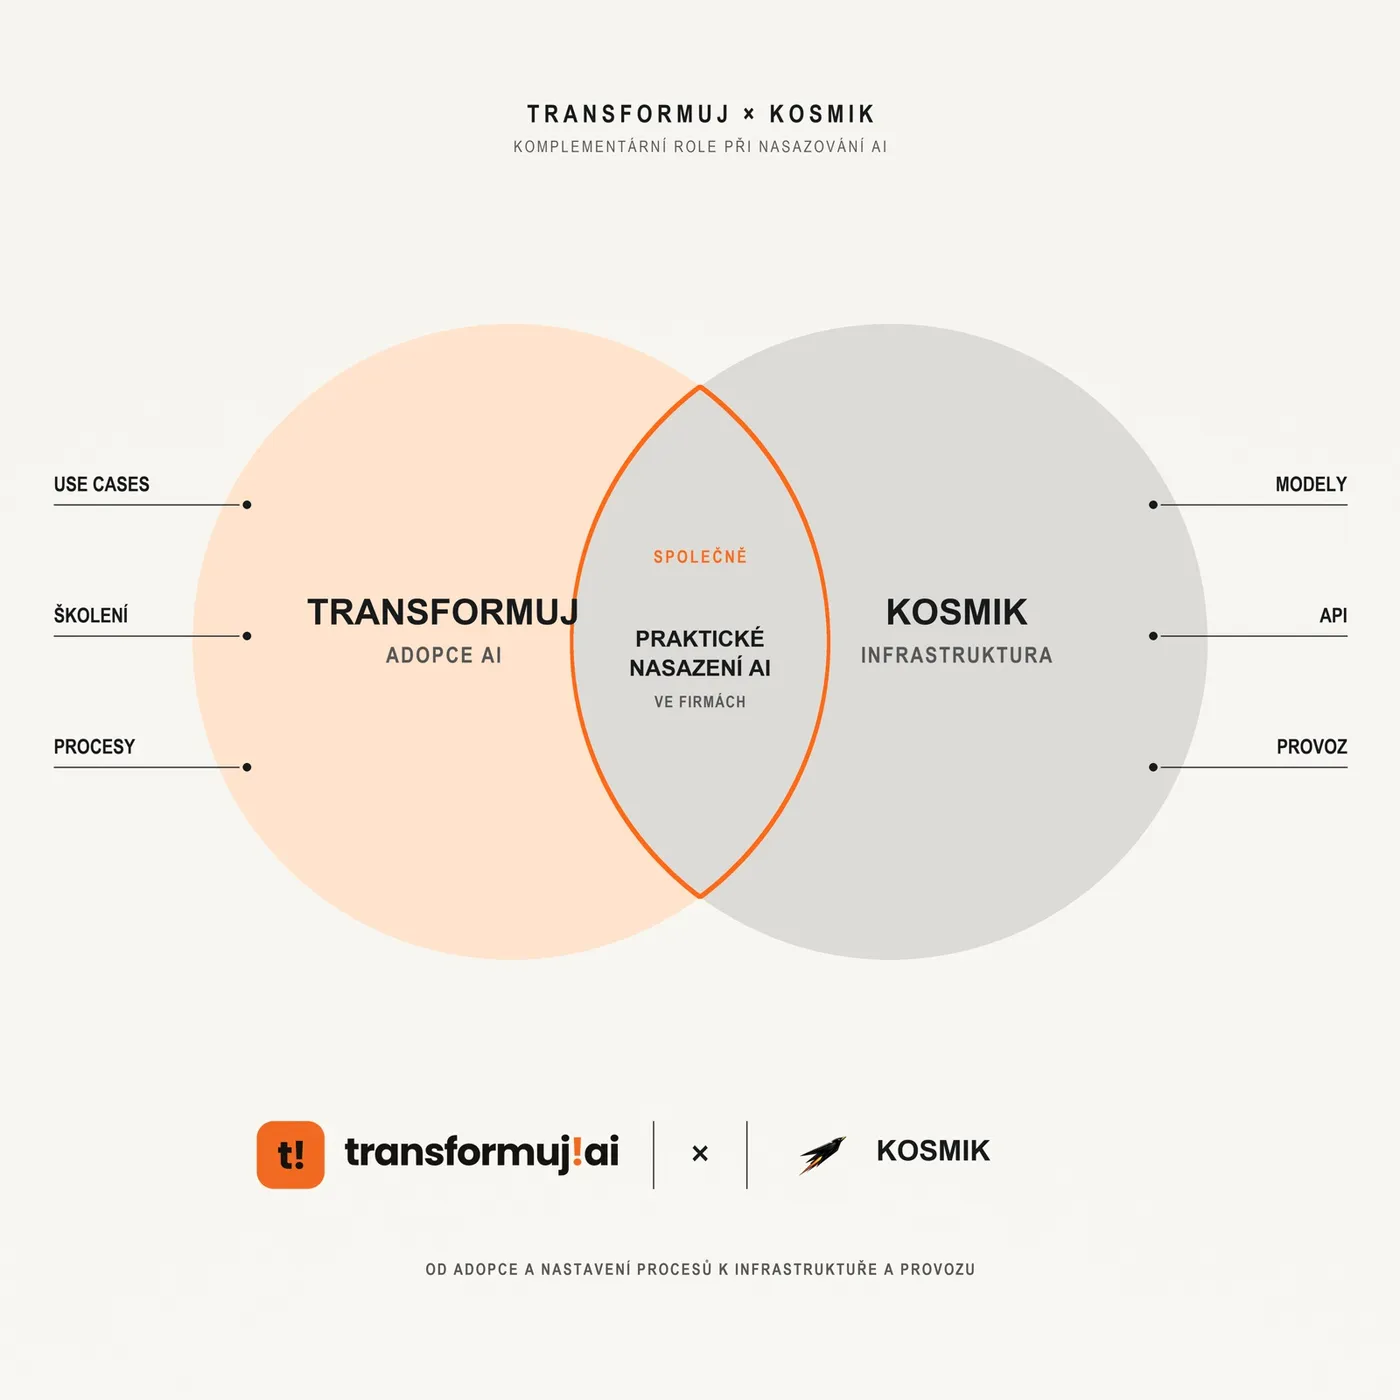
Transformuj.ai oficjalnie współpracuje z Kosmik Compute, praską infrastrukturą AI z tańszą inferencją. Podział ról jest prosty: oni trzymają wydajność, cenę za token i dane w Pradze, my budujemy na tym rozwiązania i uczymy ludzi w firmach pracować z AI.
Zanim powiedzieliśmy tak, przetestowaliśmy ich model na własnym zadaniu produkcyjnym: 35 prawdziwych transkrypcji klientów, z którymi normalnie pracujemy. Nie demo z ich strony, ale dane, na których nam zależy. Dopiero po teście przybiliśmy piątkę. Kolejność to cała pointa: najpierw liczby, potem nazwa pod ofertą.
Co z tego ma Państwa firma
Eksploatacja AI 9,7× taniej. Zmierzone względem Claude Sonnet na naszej prawdziwej partii, nie na slajdzie marketingowym. Kosmik sam na stronie reklamuje 9,1×. Przy zadaniach ekstrakcyjnych z przewagą tekstu wejściowego, czyli w większości firmowej rutyny, ich oferta wychodzi jeszcze lepiej, niż sami ją sprzedają.
Dane zostają w Pradze. Kosmik podaje, że prompty nie są logowane ani zapisywane i na danych się nie trenuje. Sprzęt działa w certyfikowanym housingu w Czechach, a eksploatacja jest zgodna z RODO. Dla ochrony zdrowia, prawa, finansów i administracji publicznej to często ważniejsze niż cena.
Skonfigurujemy to i nauczymy ludzi. Tani token sam z siebie niczego nie oszczędza. Oszczędność powstaje dopiero wtedy, gdy AI przejmie konkretną rutynę: dokumenty, e-maile, treści, kod. Dokładnie to jest nasza część pracy.
Test: 35 transkrypcji, zero błędów
Test odbył się 27. 7. 2026 na modelu Qwen 3.6 27B, jedynym, który faktycznie testowaliśmy: 35 prawdziwych transkrypcji klientów, 320 346 tokenów wejściowych i 16 724 wyjściowych, łączny czas 2,1 minuty.
Co się zgadzało: 35 z 35 transkrypcji bez błędu i bez konieczności ponawiania zapytania. Zero halucynowanych liczb, każdą daną dało się odszukać w tekście źródłowym. Structured output trafił we wszystkie 12 wymaganych pól za pierwszym razem. W 400 zapisach operacyjnych model znalazł wszystkie trzy zdarzenia nadzwyczajne i poprawnie zsumował szkodę. Czeski bez błędów. Przy dwóch nieużytecznych transkrypcjach model sam napisał, że nie da się ich przeanalizować, zamiast dopowiadać sobie treść, dokładnie takie zachowanie, jakiego oczekujemy od narzędzia do ekstrakcji.
Zakres testu. Kontekst zweryfikowaliśmy do 34,7 tysiąca tokenów z deklarowanych 262 tysięcy, zadania były ekstrakcyjne, a mierzyliśmy na współdzielonym free tierze. Copywriting to inne zadanie, model jest zbudowany do ekstrakcji danych, do tekstu na zewnątrz go nie wdrożymy. Przepustowość: na free tierze 98,6 tokenów na sekundę, Kosmik dla tieru produkcyjnego podaje 3 832 przy krótkich czatach i 1 467 przy dłuższej pracy. Tieru produkcyjnego nie mierzyliśmy, chodzi o liczby z dwóch różnych środowisk.
Co wszystko działa na Kosmiku
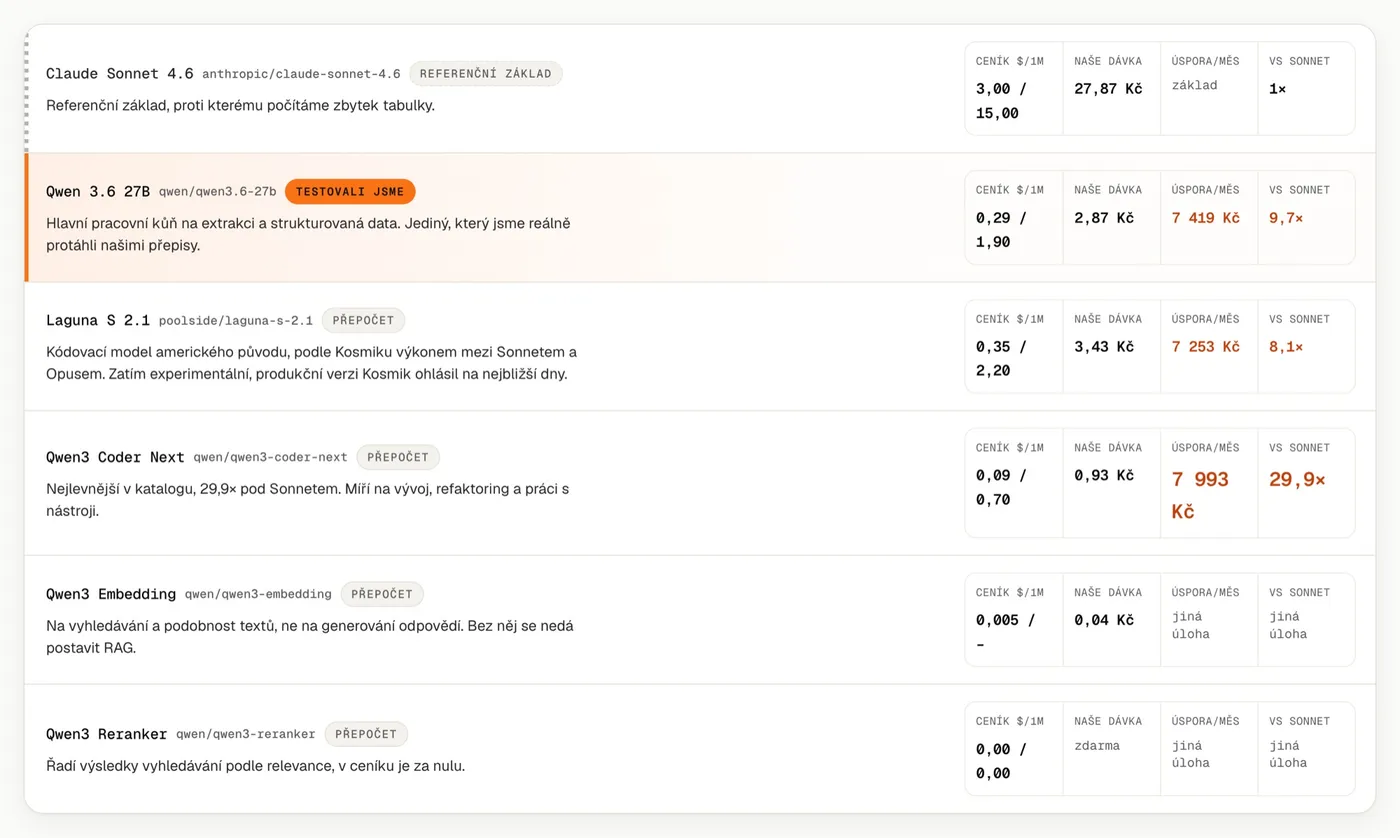
Kosmik ma w katalogu więcej modeli, przetestowaliśmy na razie jeden. Przy pozostałych chodzi o przeliczenie publicznego cennika na naszą partię, kurs 0,92 € za dolara.
Najbardziej rzucająca się w oczy liczba w tabeli nie jest nasza. Model kodujący qwen3-coder-next wychodzi na tej samej partii 29,9× taniej niż Sonnet. Dla startupów i zespołów rozwojowych to rząd wielkości, który zmienia budżet na iteracje.
Podłączenie to konfiguracja, nie projekt. API jest kompatybilne z OpenAI i Anthropic, istniejącą aplikację przełącza się zmianą dwóch zmiennych.
Ile to realnie zaoszczędzi
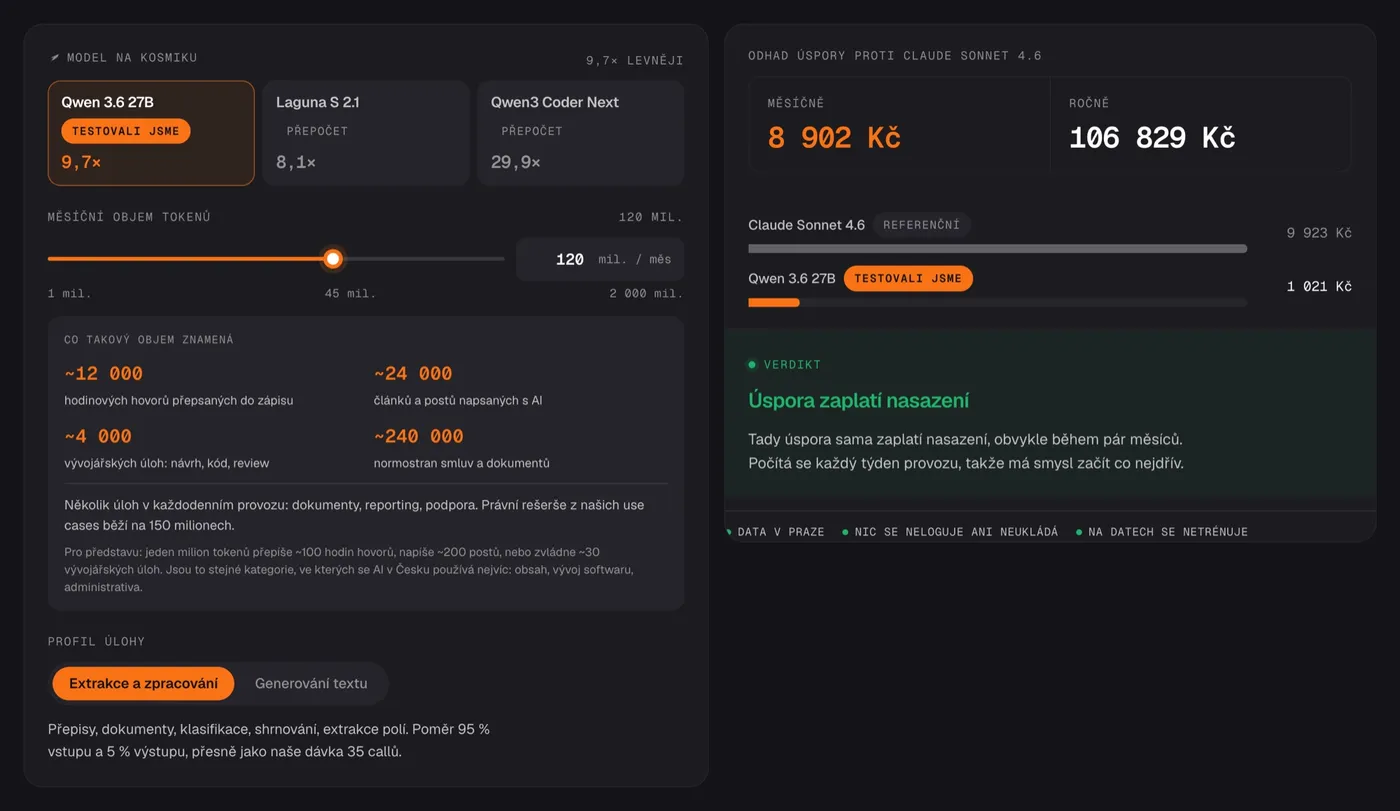
Oszczędność liczy się w tokenach miesięcznie, nie w procentach.
Małe wolumeny, do 20 milionów tokenów miesięcznie. Oszczędność to setki euro do niskich tysięcy, raczej bonus. Głównym argumentem jest eksploatacja: dane w Pradze, nic się nie loguje, koszty przewidywalne.
Wolumen małej i średniej firmy, od 20 do 100 milionów. Oszczędność jest już widoczna w budżecie operacyjnym. Placówka medyczna z 35 milionami tokenów zaoszczędzi na eksploatacji około 1 240 € rocznie i przede wszystkim: AI przetworzy za to mniej więcej 3 500 wiadomości miesięcznie, czyli setki godzin pracy personelu.
Duże wolumeny. Research prawny na 150 milionach: 5 320 € rocznie. Tworzenie oprogramowania z Coder Next na 60 milionach: 5 712 € rocznie. E-sklep z generowaniem treści na 400 milionach: 34 896 € rocznie, jedyny scenariusz, w którym rozstrzyga wyłącznie cena.
To wszystko modelowe przeliczenia z naszej partii i publicznego cennika, nie oferta cenowa. Ale rząd wielkości się zgadza.
Co pokazują dane o Czechach
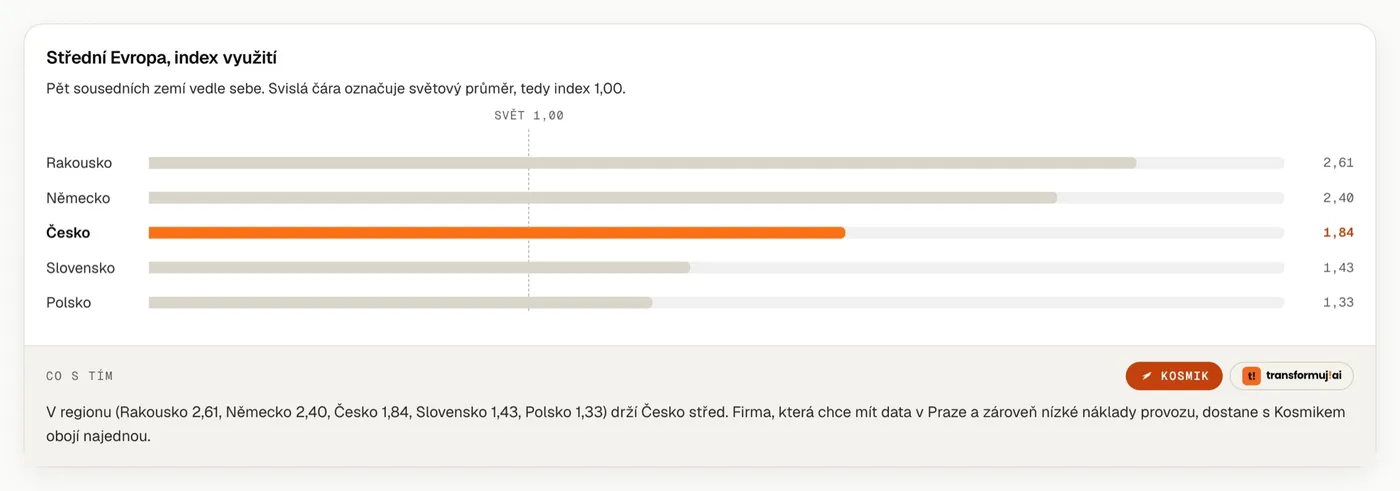
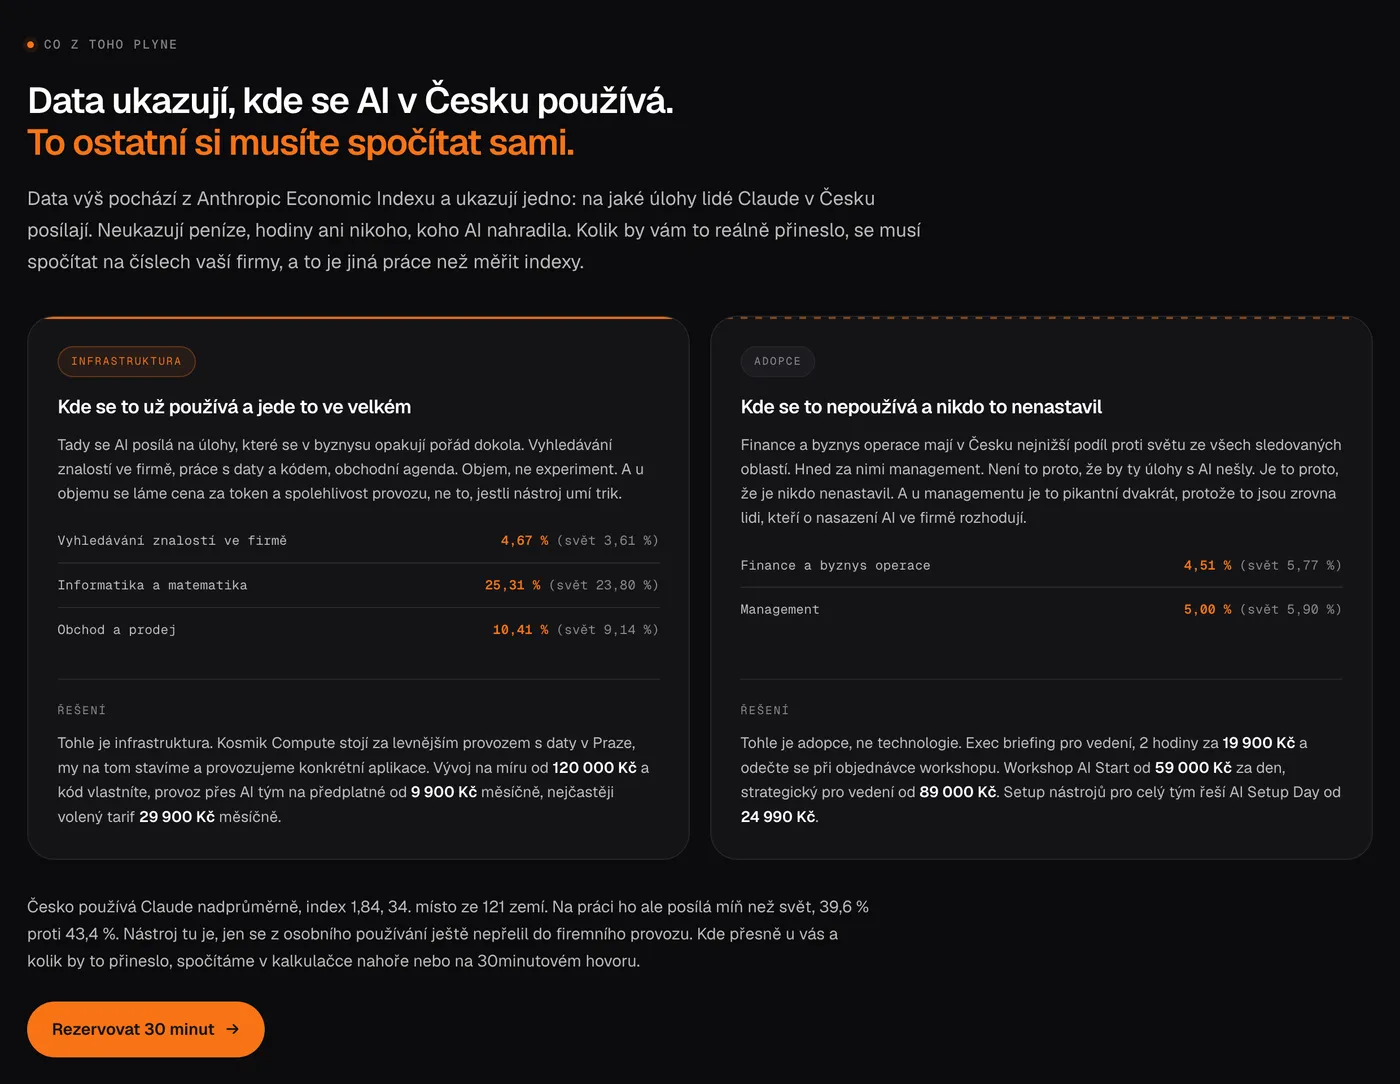
Anthropic Economic Index (maj 2026, 121 krajów) mierzy, jak i gdzie używa się Claude. Czechy są z indeksem 1,84 na 34. miejscu ze 121 krajów, używają go więc ponadprzeciętnie. Tyle że do pracy kierują go mniej niż świat, 39,6 % wobec 43,4 %. Narzędzie tu jest, tylko z osobistego używania jeszcze nie przelało się do eksploatacji firmowej.
Najniżej wobec świata są finanse i zarządzanie, czyli dokładnie miejsca, w których siedzi powtarzalna rutyna, jak raportowanie i procesy akceptacji. Nie jest tak dlatego, że z AI się nie da. Nikt tego nie skonfigurował.
Dlaczego weszliśmy w partnerstwo
Test był warunkiem, nie formalnością. Przeszedł i do tego doszły rzeczy, których na pierwszej rozmowie z Kosmikiem jeszcze nie widzieliśmy. Katalog realnie się rusza, nie wybieraliśmy partnera po jednym zdjęciu w czasie.
Co dalej
Tańszy token sam w sobie nie jest powodem do zmiany dostawcy. Równanie ma lokalizację danych, jakość na konkretnym zadaniu i wolumen, który firma realnie przetwarza. My policzyliśmy je na własnych danych i wyszło na tyle dobrze, że stoimy za tym swoim nazwiskiem.
Proszę policzyć je na swoich.
Artykuł pierwotnie ukazał się na LinkedInie. Oryginalny artykuł na LinkedInie